 ChatGPT
 Perplexity
 Claude
 Grok
Ein KI-Agent baut in wenigen Minuten eine Pipeline, sie läuft beim ersten Versuch ohne Fehler durch, und beim zweiten Lauf für denselben Tag stehen die Zahlen doppelt in der Zieltabelle. So beschreibt es der Data Engineer Volker Janz, der beim Airflow-Anbieter Astronomer arbeitet, in einem Kommentar in der Computerwoche. Der Agent hatte genau das getan, worum er gebeten wurde, nur eben nicht das, woran niemand gedacht hatte. Dieser kleine Unfall zeigt, wohin sich der Beruf verschiebt, und er beantwortet die Frage, ob KI Data Engineers ersetzt.
Nein, KI ersetzt den Data Engineer nicht. Sie übernimmt einen wachsenden Teil des Codeschreibens, aber die Verantwortung für Datenqualität, die Bedeutung der Daten und die Prüfung der Ergebnisse bleibt beim Menschen. Die Rolle verschiebt sich vom reinen Bauen von Pipelines hin zu Spezifikation, Kontext und Kontrolle.
Was verändert KI konkret an der Arbeit von Data Engineers?
Den Wandel kannst Du an der Arbeit selbst festmachen. Coding-Agenten lesen ein Repository, schreiben Dateien, führen Befehle aus und lassen Tests laufen. Über das Model Context Protocol, einen offenen Standard, lassen sich Assistenten wie Claude oder ChatGPT direkt an Datenbanken, Dateien und Werkzeuge anbinden. Das heißt: Ein erster Entwurf für ein SQL-Skript, ein Transformationsmodell oder einen Testfall entsteht heute oft in Minuten statt in Stunden.
Wie weit KI in deutschen Unternehmen schon angekommen ist, zeigt eine repräsentative Bitkom-Befragung vom September 2026: 57 Prozent setzen KI ein, 11 Prozent nutzen bereits KI-Agenten, weitere 29 Prozent planen es. Unter Datenprofis liegt die Nutzung noch höher. In einer Umfrage des Autors Joe Reis unter 1.101 Menschen aus dem Datenumfeld nutzen 82 Prozent KI täglich oder öfter. Die Antworten stammen allerdings aus seiner Newsletter-Community und sind deshalb nicht repräsentativ.
Sie sehen gerade einen Platzhalterinhalt von YouTube. Um auf den eigentlichen Inhalt zuzugreifen, klicken Sie auf die Schaltfläche unten. Bitte beachten Sie, dass dabei Daten an Drittanbieter weitergegeben werden.
Auch Data Analysts spüren diese Verschiebung, bei ihnen verändert KI vor allem das Auswerten und Berichten. Beim Engineer geht es um Pipelines, die nachts zuverlässig laufen müssen.
Was bleibt beim Menschen: Spezifikation, Kontext und Prüfung?
Die Pipeline aus dem Beispiel war nicht falsch, weil das Modell schlecht war. Sie war falsch, weil die Anweisung lautete „implementiere eine tägliche Aggregation“, und nicht „sorge dafür, dass ein erneuter Lauf desselben Tages keine Duplikate erzeugt“. Solche Lücken füllt ein Agent mit dem Naheliegendsten. Daraus ergeben sich drei Aufgaben, die laut Janz an Gewicht gewinnen.
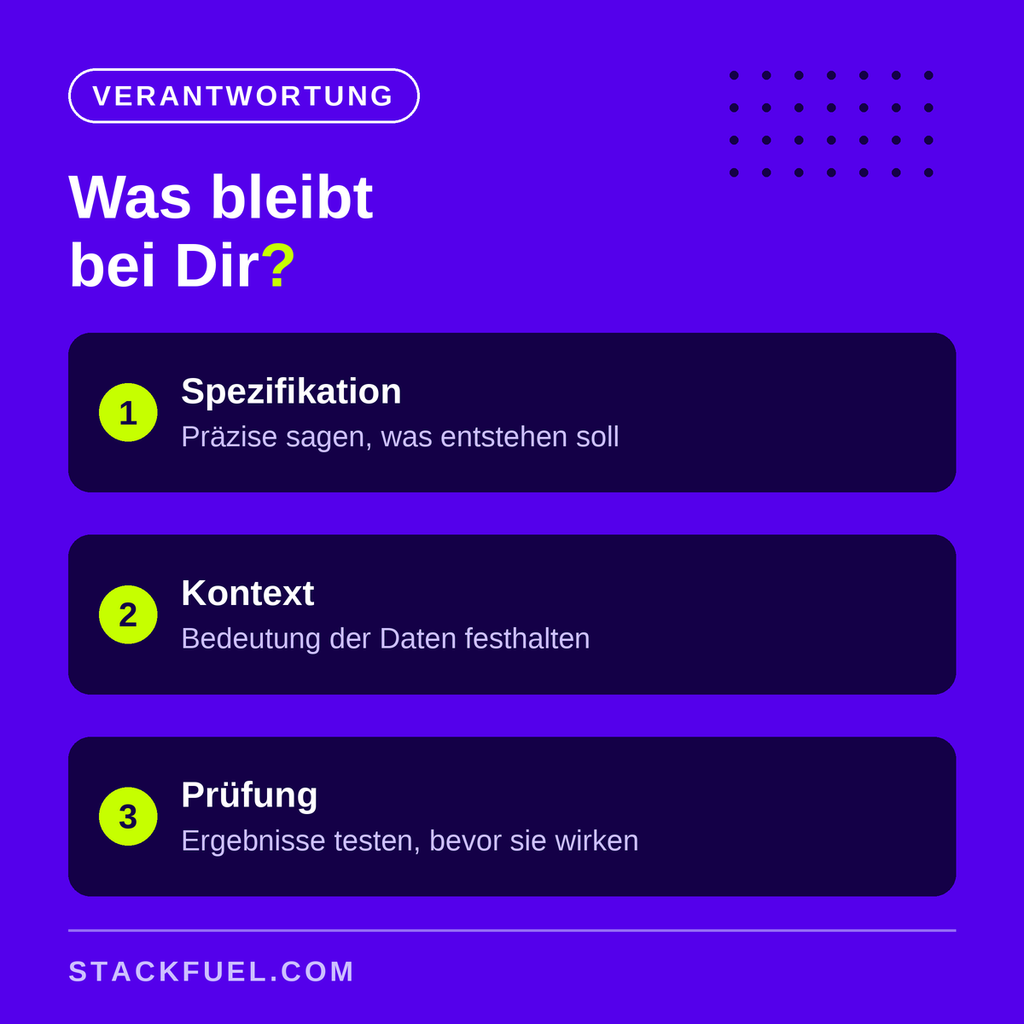
Die Spezifikation. Wer Quelltabellen, Primärschlüssel, das Verhalten bei einem erneuten Lauf und den Umgang mit fehlenden Werten benennt, bekommt ein belastbares Ergebnis. Wer „aggregiere den Umsatz pro Produkt“ schreibt, bekommt einen Prototyp. Das ist klassisches Handwerk eines Data Engineers, nur dass der Empfänger jetzt ein Agent ist.
Der Kontext. Ein Agent weiß nur, was in seinem Kontext steht: Konventionen, Schema, Namensregeln. Janz sieht den wertvollsten Kontext in der Bedeutung der Daten. Was genau ist ein „aktiver Nutzer“, wie hängen die Entitäten zusammen? Datenmodellierung wird damit zur Bedeutungsarbeit. Gleichzeitig gilt: Kontext muss kuratiert sein, nicht vollständig. Zu lange Anweisungen werden vom Modell leicht überlesen.
Die Prüfung. Agenten sind schneller, als ein Mensch ihr Ergebnis lesen kann, und sie liefern auch dann eine Antwort, wenn sie keine sichere haben. Deshalb braucht es Evaluation: Regressionstests, die zeigen, ob ein umgeschriebenes SQL-Skript dasselbe Datenergebnis liefert wie vorher. Als warnendes Beispiel nennt Janz den Chatbot von Air Canada, der 2024 eine falsche Auskunft gab und die Airline zu Schadensersatz brachte, weil der Bot auf veraltete und widersprüchliche Quellen zugriff.
Das ist ein Praktikerkommentar, keine Studie. Die Bitkom-Zahlen stützen aber die Richtung: KI-Anwender nennen die Aufbereitung von Daten (50 Prozent) und die Integration in bestehende Systeme (41 Prozent) als große Kostenpunkte, Softwarelizenzen nur 21 Prozent. Als Gedankenmodell taugt Janz‘ Einteilung deshalb: Wer Fehler in Daten erkennt, bevor sie in einem Dashboard oder Modell landen, bleibt unverzichtbar. Werkzeuge wie Apache Airflow für Orchestrierung und dbt für Transformationen bleiben dafür das Handwerkszeug, auch wenn ein Agent den ersten Entwurf liefert.
Was sagen Zahlen zur Zukunft der Rolle?
Hier lohnt es sich, Quellen zu unterscheiden. Die Joe-Reis-Umfrage fragt nach Erwartungen: 42 Prozent der Befragten rechnen damit, dass ihre Datenteams wachsen, 7 Prozent erwarten schrumpfende Teams. Das ist eine Stimmung in einer selbst ausgewählten Gruppe und keine Prognose. Als Stimmungsbild zur Zukunft des Data Engineering taugt sie trotzdem: Die Befragten rechnen eher mit mehr als mit weniger Arbeit.
Härter ist die Gehaltsseite. Die Auswertung von TalentUp aus dem Oktober 2026 vergleicht Rollen mit dem Gehalt von Software Developern. Data Engineers verdienen im Schnitt über sieben Länder 9,8 Prozent mehr, Data Scientists 5,8 Prozent weniger. Als Länderschnitt ist das kein Wert für Deutschland. Für Deutschland nennt dieselbe Auswertung AI Engineers mit 78.600 Euro gegenüber 59.300 Euro bei Software Developern, ein Plus von 32,5 Prozent. Das ist eine eigene Rolle, keine Umbenennung des Data Engineers. In Deutschland liegt das Durchschnittsgehalt für Data Engineers laut unserer Auswertung bei rund 68.500 Euro.
Was sich aus den Zahlen nicht ableiten lässt: wie viele Einstiegsstellen in zwei oder drei Jahren existieren. Wer Dir dazu eine genaue Prognose verkauft, kennt sie nicht.
Was solltest Du als angehender Data Engineer jetzt lernen?
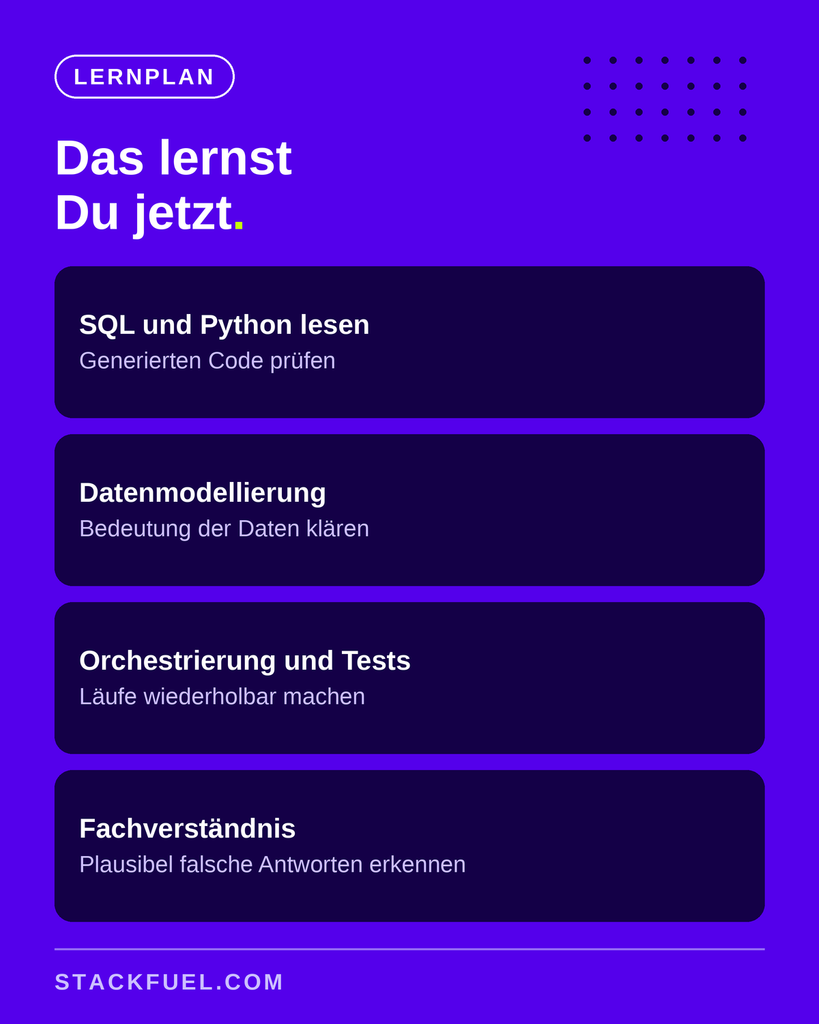
Die Grundlagen bleiben. Wer eine KI-generierte Pipeline prüfen will, muss SQL und Python lesen können und verstehen, was das Ergebnis bedeutet. Obendrauf kommen ein paar Fähigkeiten, die bislang als Zugabe galten:
| Fähigkeit | Warum sie wichtiger wird |
|---|---|
| SQL und Python lesen und prüfen | Du musst erkennen, wenn generierter Code das Falsche tut |
| Datenmodellierung | Bedeutung der Daten ist der Kontext, den ein Agent nicht selbst findet |
| Orchestrierung und Tests | Läufe wiederholbar machen, Ergebnisse automatisch prüfen |
| Spezifikationen schreiben | Präzise Anforderungen sind die neue Schnittstelle zum Agenten |
| Fachverständnis | Nur wer das Business kennt, erkennt eine plausibel falsche Antwort |
Die Reihenfolge ist dieselbe wie vorher: erst die Grundlagen, dann die Plattform. Hilfreich ist dabei ein Meilenstein für jeden der sechs Lernschritte. Im Alltag kommen Coding-Agenten im Repository und Assistenten in Databricks oder Snowflake dazu, deren Ergebnisse Du prüfen können musst.
Was bedeutet das für Deinen Einstieg?
Der Einstieg wird nicht kleiner, er verschiebt sich nach oben. Reines Abtippen von Syntax macht eine KI schneller, Verständnis für Datenflüsse, Qualität und Betrieb nicht. Wer neu im Feld ist, sollte deshalb früh ein eigenes Projekt bauen, das von der Quelle bis zur Auswertung läuft, und es mit Tests absichern. Im Alltag wechselt der Beruf zwischen Pipelines bauen und Ausfälle reparieren, und je nach Vorerfahrung führen drei Wege hinein.
Die Data Engineering Weiterbildung von StackFuel ist als fortgeschritten eingestuft und setzt Berufserfahrung in fortgeschrittenem Python oder in der Analyse großer Datensätze voraus. Sie dauert 9 bis 10 Monate in Vollzeit oder 18 bis 19 Monate in Teilzeit. Du lernst darin in acht Modulen, Daten zuverlässig zu sammeln, zu verarbeiten und für Analytics, BI und KI bereitzustellen, mit Azure, Snowflake, Synapse und Spark in Databricks, und baust ein eigenes Cloud-Projekt. Fehlt Dir die Programmierpraxis, ist ein Einstieg über Python oder Data Analyst oft der bessere erste Schritt.
Bei der Förderung gilt: Mit einem Bildungsgutschein können Agentur für Arbeit oder Jobcenter die Kosten übernehmen, wenn Du arbeitslos oder arbeitssuchend gemeldet bist. Vorher klärt die Agentur in einem Beratungsgespräch, ob Du die Voraussetzungen erfüllst und ob Kurs und Anbieter zugelassen sind.
Fazit
KI verändert den Beruf des Data Engineers, ersetzt ihn aber nicht. Das Wichtigste in Kürze:
- Was sich ändert: Agenten schreiben Entwürfe für Code, Tests und Transformationen in Minuten.
- Was bleibt: Spezifikation, Kontext und Prüfung liegen weiter beim Menschen, und sie werden wichtiger.
- Was belegt ist: 57 Prozent der Unternehmen in Deutschland setzen KI ein und investieren vor allem in Daten und Integration, und Gehaltsdaten sehen Data Engineers im Ländervergleich vorn. Eine Prognose zur Zahl der Stellen gibt es nicht.
- Was Du tun kannst: Grundlagen sicher lernen, Datenmodellierung und Tests ergänzen und ein eigenes Projekt aufbauen.
Du willst wissen, welcher Einstieg zu Deiner Situation passt? StackFuel ist seit 2020 AZAV-zertifiziert, über 8.000 Absolvent:innen haben bei uns Weiterbildungen im Daten- und KI-Bereich abgeschlossen, mit einer Abschlussquote von 93 Prozent. Gemeinsam schauen wir auf Deine Vorerfahrung, die passende Weiterbildung und die Frage der Förderung. Vereinbare dafür einfach Dein kostenloses Beratungsgespräch.
Häufige Fragen zu Data Engineer und KI
Ersetzt KI den Data Engineer?
Nein. KI übernimmt Teile des Codeschreibens, aber Spezifikation, Kontext und Prüfung der Daten bleiben beim Menschen. Die Rolle verschiebt sich hin zu Verantwortung für Datenqualität und Bedeutung der Daten.
Kann KI Datenpipelines schreiben?
Ja, als Entwurf. Ein Agent kann eine Pipeline in Minuten bauen. Ob sie bei einem erneuten Lauf, bei fehlenden Werten oder bei geänderten Quellen richtig reagiert, muss ein Mensch spezifizieren und prüfen.
Lohnt sich Data Engineering noch?
Die Zahlen sprechen nicht dagegen: Im Ländervergleich von TalentUp liegen Data Engineers 9,8 Prozent über Software Developern. Eine Garantie für Stellen in zwei bis drei Jahren ist das nicht, aber ein Hinweis, dass die Rolle gefragt ist.
Muss ich KI-Tools können, um Data Engineer zu werden?
Mit Grundlagen in SQL, Python und Datenmodellierung kommst Du weiter als mit einem einzelnen Tool. KI-Werkzeuge solltest Du kennen und kritisch einsetzen können, sie ersetzen aber nicht das Verständnis dessen, was sie erzeugen.
Was ist der Unterschied zwischen Data Engineer und AI Engineer?
Der Data Engineer stellt verlässliche Daten bereit, der AI Engineer baut Anwendungen mit KI-Modellen. In der TalentUp-Auswertung liegen AI Engineers in Deutschland bei 78.600 Euro, Software Developer bei 59.300 Euro.
Wie ist das beim Data Analyst?
Auch dort ändert KI die Arbeit, ohne den Beruf zu ersetzen. Bei ihm verschiebt sich vor allem das Auswerten und Berichten, beim Data Engineer der Bau und die Prüfung von Pipelines.